
La densità di potenza di calcolo per l'IA è cresciuta enormemente. Le GPU moderne consumano oltre 700 watt ciascuna. I vecchi case per server non sono in grado di gestire questo calore. Il tuo hardware per l'IA sta perdendo prestazioni all'interno di un case obsoleto? Questo articolo illustra l'intero processo di progettazione e realizzazione di un case per computer dedicato all'IA. Partiamo dai calcoli termici, per poi passare alla scelta dei materiali e ai metodi di raffreddamento. Scoprirai quando è preferibile un design personalizzato rispetto a soluzioni già pronte. Costruire un computer per il deep learning richiede un'attenta pianificazione. La CPU e la GPU necessitano di un buon flusso d'aria e di un supporto robusto. Un computer per il deep learning economico ed espandibile richiede scelte di configurazione intelligenti. Trattiamo le esigenze di calcolo ad alte prestazioni per ogni fase della costruzione. Il case del computer influisce su tutto, dalla rumorosità all'affidabilità. Esploriamo il processo di progettazione che permette al tuo computer per il deep learning di funzionare al massimo delle sue potenzialità.
Requisiti fondamentali per Contenitore per elaborazione AI Design
Calcolo della densità termica per GPU ad alte prestazioni
La gestione termica è alla base di ogni scelta progettuale per un case dedicato al calcolo AI. Le GPU moderne generano molto calore. Un NVIDIA H100 consuma costantemente 700 W. Il più recente B200 arriva fino a 1,000 W con raffreddamento ad aria o 1,200 W con raffreddamento a liquido. Ora pensate a questi valori sull'intero sistema.
Prendiamo un server con 8 GPU. Otto GPU da 700 W ciascuna equivalgono a 5,600 W di calore. Aggiungiamo CPU, RAM e storage (circa 800-1,200 W) più la rete (200-400 W). Il totale si aggira tra i 7,000 e gli 8,000 W per un server 2U. Riempiamo un rack 42U con dieci server di questo tipo e dovremo gestire 70-80 kW di calore. I vecchi rack ne gestiscono solo 8-15 kW. Si tratta di un aumento della densità di calore da 4 a 7 volte.
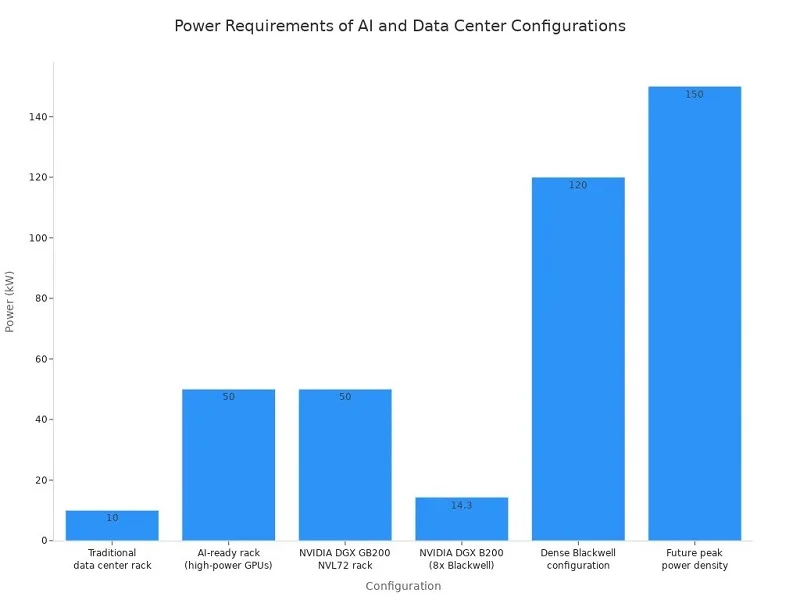
Questi calcoli determinano l'intero piano di raffreddamento. Un rack che assorbe 70-80 kW non può fare affidamento sulla normale aria condizionata. Sono necessari flussi d'aria mirati o circuiti di raffreddamento a liquido che operino con temperature di ingresso comprese tra 18 e 45 °C.
Progettazione del percorso del flusso d'aria e gestione della pressione statica
Il raffreddamento ad aria funziona per carichi medi, ma richiede una progettazione accurata. Il case per il calcolo AI deve far circolare l'aria dalla parte anteriore a quella posteriore senza vortici o zone di ristagno. Le ventole ad alta pressione statica spingono l'aria attraverso gli array di GPU ad alta densità, ma sono rumorose e vibrano. Ogni presa d'aria, condotto e deflettore modifica l'equilibrio della pressione.
Per carichi molto elevati, il raffreddamento a liquido diretto sul chip diventa la scelta migliore. I normali sistemi di raffreddamento ad aria ambiente non sono in grado di dissipare il calore in modo efficace alle densità più elevate. Il progetto deve includere collettori del liquido di raffreddamento, percorsi per i tubi e raccordi a sgancio rapido che consentano la manutenzione senza dover svuotare l'intero circuito.
Standard delle unità rack (U) e compatibilità con i formati da 19 pollici
Il tuo rack per l'intelligenza artificiale deve essere compatibile con le apparecchiature standard dei data center. Il formato rack da 19 pollici e le misure di altezza dell'unità rack (U) rimangono la base. Tuttavia, i sistemi di intelligenza artificiale ad alta densità spesso superano i limiti di peso standard. Un rack completo può pesare dalle 10 alle 20 tonnellate o più. I pavimenti sopraelevati standard potrebbero richiedere supporti aggiuntivi o basamenti in cemento progettati per carichi distribuiti.
| Dominio delle prestazioni | Indicatore/Requisito chiave |
| Termico | Dissipazione del calore a 300-400 kW per rack; raffreddamento a liquido necessario; temperatura uniforme per evitare stress termici |
| Strutturale | Peso elevato che richiede un supporto speciale per il pavimento; le dimensioni potrebbero differire dallo standard di 19 pollici |
| CONDUCIBILITA | Centinaia di kW per rack; grandi sbarre collettrici; distribuzione a 380-415 V CA o 48 V CC |
Rigidità del materiale per lo smorzamento delle vibrazioni
Le ventole veloci creano vibrazioni costanti. La rigidità del contenitore determina quanta energia raggiunge i componenti sensibili. L'acciaio offre maggiore rigidità e schermatura EMI. L'alluminio offre un migliore flusso di calore ma minore smorzamento. Molti progetti combinano intenzionalmente entrambi i materiali.
I terremoti rappresentano un'ulteriore fonte di preoccupazione. Lo standard Telcordia GR-63-CORE definisce le norme di resistenza alle vibrazioni per le apparecchiature dei data center. I rack costruiti secondo questo standard, come l'AMCO Titan ZN4 DT, possono supportare fino a 544 kg (1,200 libbre) mantenendo la loro robustezza anche in caso di terremoto.
Pianificazione per una maggiore densità di server
Il tuo chassis per il calcolo AI deve essere scalabile. La densità dei rack sta passando da decine di kilowatt a 100-200 kW e oltre. Una soluzione valida oggi potrebbe non esserlo domani. Scegli una configurazione che possa supportare fino a 4 GPU ora, per poi scalare a 8 o più man mano che i carichi di lavoro aumentano. I collegamenti modulari per alimentazione e raffreddamento consentono di aggiungere capacità senza dover sostituire l'intero chassis.
Progettazione per cicli di aggiornamento hardware rapidi
Le generazioni di GPU si susseguono rapidamente. La H100 ha lasciato il posto alla H200, poi alla B200, ognuna con esigenze diverse in termini di alimentazione e raffreddamento. Il tuo chassis per il calcolo AI deve essere compatibile con il nuovo hardware senza grandi modifiche. Punti di montaggio standard, percorsi flessibili per i cavi e aree di manutenzione semplificate riducono i tempi di aggiornamento. La disposizione degli slot PCIe deve essere adatta a diverse dimensioni di schede e connettori di alimentazione. Questa progettazione lungimirante protegge il tuo investimento infrastrutturale attraverso numerose generazioni di hardware.
Costruire un computer per il deep learning significa trovare un equilibrio tra esigenze contrastanti. Prestazioni termiche, robustezza strutturale e flessibilità futura sono tutti fattori importanti. Un buon case per computer dedicati all'intelligenza artificiale integra questi elementi in un unico sistema che garantisce prestazioni ottimali dell'hardware per anni.
Materiali e Produzione di contenitori per sistemi di calcolo basati sull'intelligenza artificiale
Scegliere i materiali giusti per prestazioni e durata
Leghe di alluminio contro acciaio zincato
La scelta del materiale influisce sull'intero processo produttivo. L'alluminio 6061 è il migliore per la gestione del calore. Dissipa rapidamente il calore da GPU e CPU. Questo è importante quando ogni GPU consuma oltre 700 watt. Questo metallo è anche leggero, il che è un vantaggio quando si installano molte unità in un rack.
L'acciaio zincato (SGCC) offre diversi vantaggi. Blocca le interferenze elettromagnetiche meglio dell'alluminio, un aspetto importante per l'hardware di intelligenza artificiale che opera ad alte velocità. L'acciaio, inoltre, resiste meglio alle vibrazioni delle ventole rispetto ai metalli più morbidi. Molti progetti di chassis per sistemi di calcolo AI utilizzano entrambi i materiali: l'alluminio per i dissipatori di calore e le piastre di raffreddamento, e l'acciaio per il telaio esterno e le schermature EMI.
La scelta dipende dal piano di raffreddamento. Se è necessaria la migliore dissipazione del calore, è preferibile l'alluminio. Se invece è fondamentale ridurre le interferenze elettriche, l'acciaio è più indicato. Un progetto personalizzato può utilizzare entrambi i materiali in un'unica struttura. Questa è una sfida fondamentale nella realizzazione di sistemi di intelligenza artificiale: bilanciare le esigenze termiche ed elettriche all'interno di un unico involucro.
Finitura superficiale: anodizzazione per resistenza alla corrosione
L'alluminio grezzo reagisce con l'aria nel tempo. Questa reazione può compromettere il trasferimento di calore. L'anodizzazione crea uno strato di ossido controllato sulla superficie. Ciò protegge il metallo dalla ruggine e dall'usura, rendendo inoltre la superficie più dura.
Per i case dei computer dedicati all'intelligenza artificiale, l'anodizzazione è una pratica comune per i dissipatori di calore e le piastre di raffreddamento. Il rivestimento mantiene la pasta termica in perfette condizioni. Senza di esso, la ruggine può creare minuscole fessure che impediscono la dissipazione del calore. Una buona finitura è anche esteticamente gradevole per i componenti rivolti al cliente. Il processo ha un costo leggermente superiore, ma rende il computer per il deep learning più affidabile.
Lavorazione CNC per componenti di precisione
Ottenere tolleranze ristrette per le alette del dissipatore di calore
I dissipatori di calore per le GPU dedicate all'intelligenza artificiale richiedono una precisione elevatissima. Le alette devono essere dritte e distanziate uniformemente. Anche il minimo errore può bloccare il flusso d'aria o compromettere l'adesione della pasta termica.
La superficie deve essere piana entro ±0.05 mm. Superfici irregolari possono creare intercapedini d'aria. Queste intercapedini possono ridurre le prestazioni termiche fino al 50%. Utilizzare lavorazioni di precisione come la fresatura a disco, la spianatura o la fresatura di precisione per ottenere una finitura a specchio.
Ecco le tolleranze usuali per un dissipatore di calore lavorato a CNC:
| Caratteristica della geometria dell'aletta | Tolleranza raggiungibile |
| Spessore delle alette | ± 0.05 mm |
| Distanza tra le alette | ± 0.05 mm |
| planarità della superficie di montaggio | 0.01–0.02 mm |
Queste tolleranze vengono impostate durante lo stesso taglio che modella le alette. Ciò evita errori derivanti da passaggi multipli. La precisione è molto più elevata rispetto all'estrusione standard. Garantisce un contatto perfetto con la pasta termica o il pad.
La lavorazione CNC è ideale per produzioni da basse a medie. Consente di modificare facilmente il design dei pezzi, cosa impossibile con l'estrusione. È possibile regolare la forma delle alette tra una produzione e l'altra senza bisogno di nuovi utensili. Questo è particolarmente utile quando si cambia la GPU e si ha bisogno di nuovi pezzi rapidamente.
Lavorazione di elementi complessi del telaio
Anche il telaio necessita di lavorazione CNC. I fori per le schede PCIe devono essere perfettamente allineati. I distanziatori per la scheda madre devono avere l'altezza corretta. I percorsi dei cavi devono essere lisci e privi di spigoli vivi.
Una costruzione personalizzata consente di migliorare queste caratteristiche per il proprio hardware. È possibile aggiungere inserti filettati per un facile accesso. È possibile realizzare alloggiamenti per i cavi. Questa soluzione è ideale per prototipi e piccole produzioni. In questo caso, l'involucro diventa uno strumento di precisione che supporta ogni componente al suo interno.
Fabbricazione della lamiera per la produzione su larga scala
Taglio laser e Precisione Piegatura di lamiere
Quando hai bisogno di centinaia o migliaia di unità, la lavorazione della lamiera è la soluzione ideale. Il taglio laser produce bordi netti e privi di sbavature. Il taglio segue il tuo progetto CAD entro limiti ristretti.
La piegatura di precisione modella quindi le lamiere piatte in forme tridimensionali. Una pressa piegatrice piega il metallo lungo linee prestabilite. L'angolo di piegatura è fondamentale per la resistenza. Se è troppo acuto, il metallo si crepa. Se è troppo ampio, il telaio oscilla. Le officine specializzate regolano queste impostazioni per ogni spessore di metallo. È qui che il vostro progetto incontra i limiti del mondo reale.
Saldatura di lamiere e aggiunta di hardware
La saldatura unisce pannelli separati in un'unica struttura robusta. La saldatura a punti è adatta per lamiere sottili, mentre la saldatura TIG è indicata per pezzi più spessi. Entrambe creano una struttura solida che tiene tutto in posizione.
L'inserimento di componenti hardware crea fori filettati dopo la saldatura. Dadi a pressione, inserti PEM e dadi saldati sono tutti adatti. Permettono di fissare e rimuovere i componenti durante l'assemblaggio. Questo è fondamentale per un case per sistemi di calcolo AI che necessita di riparazioni. È possibile sostituire una ventola, aggiungere una GPU o sostituire un alimentatore senza attrezzi speciali. Un buon accesso per la manutenzione consente di risparmiare ore durante gli interventi.
Questi metodi, combinati insieme, formano un flusso di lavoro completo. La lavorazione CNC gestisce componenti di precisione. La lavorazione della lamiera consente di gestire volumi maggiori. La giusta combinazione offre un robusto chassis per il calcolo AI, efficiente e durevole.
Integrazione dei sistemi di raffreddamento e dell'architettura interna
Progettazione del raffreddamento ad aria: condotti e vassoi per le ventole
Gestione del rumore acustico negli ambienti dei data center
Il raffreddamento ad aria crea un problema di rumore che non si può ignorare. I moduli ventola ad alte prestazioni nei rack dei server raggiungono fino a 96 dBA. Le aree server medie si attestano intorno ai 92 dBA. I rack per AI/GPU aumentano ulteriormente questo valore, aggiungendo dagli 8 ai 15 dBA rispetto ai rack standard. I livelli di rumore nelle corsie calde raggiungono quindi i 94-98 dBA.
Questi valori sono importanti per la sicurezza dei lavoratori. L'OSHA (Occupational Safety and Health Administration) fissa il livello di intervento a 85 dBA. Qualsiasi valore superiore richiede l'utilizzo di dispositivi di protezione dell'udito. Il costante ronzio acuto delle ventole alla massima velocità può causare una perdita dell'udito graduale e permanente nei tecnici che lavorano in ambienti caldi. La progettazione del vostro ambiente di elaborazione AI dovrebbe includere materiali fonoassorbenti e curve di velocità delle ventole intelligenti. Queste riducono la velocità delle ventole quando le temperature lo consentono.
Implementazione di moduli ventola ridondanti e sostituibili a caldo
La configurazione interna deve essere incentrata sulla facilità di manutenzione. Ventole e filtri devono essere sostituibili a caldo. Questo riduce i tempi di inattività. Il guasto di una ventola non dovrebbe arrestare l'intero computer dedicato al deep learning. I moduli ventola ridondanti consentono di estrarre una ventola e inserirne una nuova senza interrompere il funzionamento del sistema.
Progetta il vassoio delle ventole con chiusure senza attrezzi e LED di stato chiari. Posiziona le ventole dove il flusso d'aria è più importante. Di solito questo significa convogliare aria fresca sui gruppi di GPU e CPU. Questo approccio mantiene l'hardware in funzione durante la manutenzione, evitando spegnimenti completi.
Integrazione del raffreddamento a liquido per carichi termici estremi
Montaggio della piastra di raffreddamento e instradamento dei tubi
Il raffreddamento a liquido diretto sul chip gestisce i carichi termici più elevati. Le piastre di raffreddamento si montano direttamente sui package di GPU e CPU e dissipano il calore molto più velocemente dell'aria. Questa differenza si riflette anche nel costo. Il raffreddamento ad aria con unità CRAC/CRAH e scambiatori di calore posteriori costa dai 1,800 ai 3,200 dollari per kW. Il raffreddamento a liquido diretto sul chip costa dai 3,500 ai 5,000 dollari per kW. Le opzioni a immersione hanno un costo ancora maggiore.
| Soluzione di raffreddamento | Spese in conto capitale per kW |
| Raffreddamento ad aria (perimetro CRAC/CRAH + scambiatore di calore porta posteriore) | $ 1,800- $ 3,200 |
| Raffreddamento a liquido diretto sul chip (piastre fredde) | $ 3,500- $ 5,000 |
| Raffreddamento a immersione monofase | $ 4,300- $ 6,000 |
| Raffreddamento a immersione bifase | $ 4,500- $ 6,500 |
Il percorso dei tubi richiede un'attenta pianificazione. È preferibile avere percorsi brevi e diretti tra il collettore e ogni piastra di raffreddamento. Le curve strette limitano il flusso. Ogni punto di connessione può presentare perdite, quindi è meglio ridurli al minimo. Utilizzare raccordi a sgancio rapido. Questi consentono di intervenire su un singolo nodo senza dover svuotare l'intero circuito.
Meccanismi di rilevamento perdite e di arresto di sicurezza
La prevenzione delle perdite inizia con il test di pressione di ogni circuito assemblato prima dell'uso. Sono inoltre necessari sensori lungo il percorso dei tubi. Questi rilevano l'umidità precocemente, prima che raggiunga i componenti elettronici sensibili. Le valvole di sicurezza con funzione di intercettazione dovrebbero isolare autonomamente la sezione che presenta perdite. Ciò protegge il vostro investimento e previene costosi danni alle apparecchiature vicine.
Distribuzione di energia e gestione dei cavi
Layout delle barre bus ad alta corrente per l'alimentazione della GPU
Le moderne GPU assorbono enormi quantità di corrente. Una singola GPU può consumare centinaia di watt. Un intero rack di GPU richiede un'alimentazione elettrica considerevole. Le barre collettrici gestiscono questo carico meglio dei normali cavi. Trasportano correnti elevate con una minore caduta di tensione e producono meno calore. Nella progettazione del circuito, le barre collettrici dovrebbero essere corte e spesse. Utilizzare un isolamento adeguato e coperture sicure al contatto.
Instradamento dei cavi per un flusso d'aria ottimale e un facile accesso per la manutenzione.
La gestione dei cavi influisce sia sul raffreddamento che sulla manutenzione. I cavi disordinati bloccano il flusso d'aria e creano punti caldi. Inoltre, rendono frustrante la sostituzione dei componenti. Instradate i cavi di alimentazione e dati lungo i bordi del case, tenendoli lontani dal flusso d'aria principale. Utilizzate canaline e fascette in velcro per mantenere l'ordine. Etichettate chiaramente ogni cavo. Questa scelta progettuale si rivelerà vantaggiosa ogni volta che effettuerete la manutenzione del sistema.
Una buona gestione dei cavi facilita anche gli aggiornamenti futuri. Quando si aggiunge una nuova scheda PCIe o si sostituisce una GPU, è possibile raggiungere il connettore corretto senza dover districare un groviglio di cavi. Questo mantiene l'infrastruttura di calcolo AI adattabile alla crescita dei carichi di lavoro. L'architettura interna scelta oggi determina la facilità con cui sarà possibile aggiungere nuovi componenti in futuro. Pianificate fin da subito l'accesso per la manutenzione. L'infrastruttura del vostro data center funzionerà in modo più fluido per anni.
Scalabilità e progettazione modulare per la crescita dell'IA
Architetture di chassis modulari per una distribuzione flessibile
Aggiunta o rimozione dinamica di nodi di calcolo
I carichi di lavoro dell'IA cambiano rapidamente. Un'attività di addestramento che oggi richiede otto GPU potrebbe richiederne solo due per l'inferenza domani. I design modulari degli chassis consentono ai team di aggiungere o rimuovere nodi di calcolo in base all'evoluzione dei carichi di lavoro. In questo modo si evita la sostituzione completa dello chassis ogni volta che cambiano i requisiti. Questo approccio protegge il budget e la disponibilità del sistema.
Immaginate ogni nodo di calcolo come un elemento costitutivo. Iniziate con un sistema espandibile fino a 4 GPU per le prime sperimentazioni. In seguito, potete aggiungere altri nodi senza dover ricablare l'intero rack. Il backplane dell'involucro gestisce le connessioni. Il vostro computer per il deep learning cresce di pari passo con i vostri progetti. Questa flessibilità è fondamentale quando non è possibile prevedere le esigenze del trimestre successivo.
Interfacce modulari standardizzate per sostituzioni rapide
Le interfacce standardizzate rendono le sostituzioni rapide e indolori. Ogni nodo utilizza lo stesso connettore di alimentazione, lo stesso collegamento dati e gli stessi punti di montaggio. Un tecnico può rimuovere un nodo guasto e inserirne uno di ricambio in pochi minuti. Non sono necessari strumenti speciali. Nessuna incertezza su quale cavo vada dove.
Questa filosofia progettuale si estende anche ai moduli di storage e di rete. È possibile combinare nodi GPU con nodi solo CPU nello stesso chassis. Le connessioni PCIe vengono instradate automaticamente in base ai componenti installati. L'hardware rimane utilizzabile più a lungo perché può essere riconfigurato per nuove esigenze. L'approccio modulare trasforma il rack in una cassetta degli attrezzi flessibile anziché in una macchina fissa.
Strategie di prefabbricazione per le infrastrutture dei data center
Moduli di contenimento assemblati in fabbrica
Costruire un impianto di intelligenza artificiale su larga scala in loco richiede mesi. I moduli prefabbricati per data center dedicati all'IA cambiano radicalmente questa tempistica. I produttori assemblano rack completi nei loro stabilimenti, installando i circuiti di raffreddamento, la distribuzione dell'alimentazione e la gestione dei cavi prima della spedizione. Il vostro team riceverà un'unità testata e pronta all'uso.
Questo approccio sposta il lavoro dal cantiere alla fabbrica. Le condizioni di fabbrica offrono un controllo qualità migliore rispetto a un cantiere polveroso. I tecnici seguono sempre le stesse procedure. Ogni modulo viene testato prima della spedizione. L'infrastruttura del data center arriva con meno sorprese e meno difetti nascosti.
Riduzione dei tempi e degli errori di installazione in loco.
L'assemblaggio in loco comporta dei rischi. Gli operai potrebbero disallineare le guide o stringere eccessivamente i raccordi. La prefabbricazione elimina la maggior parte di queste variabili. Ogni modulo si collega ai moduli adiacenti tramite interfacce standardizzate. La squadra di installazione segue una semplice sequenza: posizionamento, allineamento, collegamento, verifica.
Il risparmio di tempo si accumula rapidamente. Un progetto che potrebbe richiedere settimane di lavoro in loco si riduce a pochi giorni. I vostri data center basati sull'IA iniziano a generare valore più velocemente. La riduzione del tasso di errore si traduce anche in un minor numero di interventi di assistenza e meno rilavorazioni. Il vostro team infrastrutturale può concentrarsi sull'ottimizzazione delle prestazioni anziché sulla correzione degli errori di installazione.
Sistemi di elaborazione AI edge per implementazioni distribuite
Progetti rinforzati per ambienti non destinati ai data center.
Le implementazioni edge si trovano al di fuori dei data center puliti e climatizzati. Sono collocate su pavimenti di fabbriche, torri di parchi eolici e pali della luce. Questi ambienti richiedono contenitori per il calcolo AI robusti, in grado di resistere a polvere, umidità e sbalzi di temperatura. Il sistema di classificazione IP indica il livello di protezione offerto da un contenitore al suo interno.
Scegli IP67 per installazioni esterne esposte a condizioni atmosferiche avverse. Resiste all'ingresso di polvere e all'immersione temporanea in acqua. Scegli IP65 per ambienti esterni protetti o interni dove la pioggia non può raggiungere direttamente l'unità. Utilizza custodie predisposte per i connettori per un'installazione più rapida e un minor numero di punti di guasto. La giusta classificazione previene costose riparazioni sul campo.
I test per ottenere un grado di protezione IP superiore a 55 simulano condizioni estreme come pioggia battente, immersione in acqua pressurizzata ed esposizione alla polvere. La prototipazione di contenitori con grado di protezione IP55+ ha un costo significativamente superiore rispetto alle versioni non certificate. La stampa 3D non consente di raggiungere tali gradi di protezione a causa della penetrazione dell'acqua tra gli strati e dei problemi di tolleranza delle guarnizioni dovuti al ritiro. La prototipazione richiede lo stampaggio a iniezione o stampi in silicone, entrambi con conseguenti costi iniziali elevati.
La differenza di costo tra le diverse classificazioni di grado di protezione si fa sentire nel tempo. Gli involucri IP65 costano dal 20% al 30% in meno rispetto alle versioni IP67. Tuttavia, in ambienti esposti all'acqua, il loro tasso di guasto è 2-3 volte superiore. Una singola riparazione costa dai 5,000 ai 10,000 yuan. Un sistema di illuminazione stradale ha ridotto i costi totali da 80,000 a 30,000 yuan dopo il passaggio a IP67. Il prezzo iniziale più elevato si è ripagato grazie al minor numero di guasti.
Capacità di inferenza locale senza dipendenza dal cloud
I sistemi edge spesso eseguono l'inferenza locale. Elaborano i dati nel luogo in cui vengono generati, eliminando la necessità di una connettività cloud costante. Un sistema di visione industriale può ispezionare i prodotti anche in caso di interruzione della connessione internet. Un sistema di monitoraggio per turbine eoliche può prevedere i guasti senza inviare dati a un server remoto.
Questa elaborazione locale riduce drasticamente la latenza. Le decisioni vengono prese in millisecondi anziché in secondi. Inoltre, riduce i costi di larghezza di banda. I data center dedicati all'IA gestiscono i carichi di lavoro di addestramento più impegnativi, mentre le unità edge gestiscono le risposte in tempo reale. Insieme, formano un'infrastruttura completa che bilancia velocità e scalabilità. Il robusto case protegge il computer interno, mentre il design modulare mantiene aperte le possibilità di aggiornamento per l'hardware futuro.
Protocolli di test, convalida e garanzia della qualità
Validazione termica: simulazione vs. test fisici
Utilizzo della fluidodinamica computazionale (CFD) per prevedere i punti critici prima della prototipazione
Il software di fluidodinamica computazionale (CFD) consente di visualizzare i modelli di flusso d'aria prima ancora di tagliare il metallo. Si modella il case per il processore AI, si posizionano virtualmente GPU e CPU al suo interno e si simula il flusso d'aria attraverso il case. Il software mostra i punti caldi, le zone morte e i percorsi di ricircolo che potrebbero surriscaldare l'hardware.
Questa analisi preliminare consente di risparmiare denaro reale. Un difetto di progettazione individuato in simulazione non costa nulla da correggere. Lo stesso difetto, se scoperto dopo la realizzazione degli stampi, costa migliaia di euro. È possibile testare diverse posizioni delle ventole, forme dei condotti e dimensioni delle prese d'aria senza dover costruire nulla. La fluidodinamica computazionale (CFD) permette inoltre di confrontare il raffreddamento ad aria con quello a liquido per un carico termico specifico. In questo modo si può capire quale approccio mantiene ogni componente entro l'intervallo di temperatura di sicurezza.
Ma la simulazione ha dei limiti. Le ventole reali si comportano in modo diverso da quelle simulate. I dissipatori di calore delle GPU reali presentano tolleranze di fabbricazione. I fasci di cavi possono ostruire il flusso d'aria in modi che il software non è in grado di prevedere. Ecco perché i test fisici sono ancora importanti.
Test di stress ambientale per la valutazione dell'affidabilità
Il test di stress ambientale (ESS) spinge il prototipo oltre le normali condizioni operative. Il contenitore per l'elaborazione AI viene sottoposto a temperature estreme, cicli rapidi tra caldo e freddo e funzionamento in condizioni di elevata umidità. Questi test mettono in luce saldature deboli, ventole difettose e interfacce termiche al limite.
ESS individua i problemi che si manifestano solo sotto stress. Un connettore che funziona correttamente a temperatura ambiente potrebbe smettere di funzionare a 50 °C. Un cuscinetto della ventola potrebbe emettere un cigolio dopo cicli termici. Individuare questi problemi durante lo sviluppo è molto più efficace che scoprirli in produzione. Il tuo computer per il deep learning deve funzionare in modo affidabile per anni. ESS ti dà la certezza che ciò accadrà.
Test di conformità meccanica e di sicurezza
Procedure di prova per vibrazioni, urti e cadute
Il tuo chassis per il calcolo AI sarà soggetto a sollecitazioni fisiche. Le ventole creano vibrazioni costanti. Il trasporto può causare urti e cadute. Gli eventi sismici possono scuotere interi rack. I test meccanici simulano queste condizioni in un laboratorio controllato.
I test di vibrazione prevedono il montaggio dell'involucro su un banco vibrante. Il banco riproduce lo spettro di frequenza del funzionamento reale. Si osservano le frequenze di risonanza che amplificano il movimento. Componenti che si allentano o cavi che si sfregano indicano problemi di progettazione. I test di urto simulano impatti improvvisi. I test di caduta verificano che l'imballaggio protegga l'unità durante il trasporto. Ogni test segue procedure consolidate con criteri di superamento/fallimento.
Orientarsi tra le certificazioni UL, CE e FCC
La certificazione dimostra che il vostro contenitore soddisfa gli standard di sicurezza e di emissioni. La norma UL 62368-1 riguarda la sicurezza delle apparecchiature IT. Tratta i rischi di scosse elettriche, incendi e pericoli meccanici. La marcatura CE indica la conformità ai requisiti dell'Unione Europea. La norma FCC Part 15 regola le emissioni elettromagnetiche negli Stati Uniti.
Queste certificazioni richiedono test documentati. Sono necessari rapporti di laboratorio, file di progettazione e, a volte, ispezioni in loco. Il processo richiede settimane o mesi. Pianificatelo fin dalle prime fasi del progetto. Un case personalizzato per il calcolo AI necessita di più test rispetto a un'unità standard disponibile sul mercato. Prevedete un budget adeguato.
Controllo di qualità nel processo di produzione
Ispezione del primo articolo (FAI) per componenti di precisione
L'ispezione del primo articolo (FAI) verifica che il processo produttivo realizzi pezzi conformi al progetto. Si misurano tutte le dimensioni della prima unità prodotta e si confrontano queste misurazioni con il modello CAD e le tolleranze. La FAI individua gli errori di attrezzaggio prima che compromettano migliaia di unità.
Per componenti di precisione come i dissipatori di calore, l'ispezione delle alette (FAI) è fondamentale. Un errore di spaziatura delle alette di 0.05 mm potrebbe non essere visibile a un rapido controllo visivo, ma riduce le prestazioni termiche. La documentazione FAI è utile anche quando si cambia fornitore o processo produttivo, fornendo un punto di riferimento per confronti futuri.
fine montaggio e procedure di test di burn-in
Il test di burn-in prevede di sottoporre i case completi a carico per periodi prolungati. Si installano GPU fittizie o schede di calcolo reali e li si fa funzionare a piena potenza per ore o giorni. Questo test rileva guasti intermittenti che si manifestano solo dopo il riscaldamento. Connessioni allentate, alimentatori difettosi e sistemi di raffreddamento inadeguati si rivelano durante il burn-in.
Il test convalida anche l'integrazione del sistema. Confermate che la distribuzione dell'alimentazione funzioni correttamente. Verificate che il raffreddamento mantenga ogni componente entro le specifiche. Controllate che l'interfaccia di gestione riporti le temperature in modo accurato. Solo dopo aver superato il burn-in, il vostro contenitore viene spedito al cliente. Quest'ultima fase tutela la vostra reputazione e la disponibilità del sistema del cliente.
Collaborazione con NOBLE per la produzione di contenitori per sistemi di calcolo basati sull'intelligenza artificiale.

Capacità produttive complete riunite sotto un unico tetto.
Lavorazioni CNC e fabbricazione di lamiere interne
NOBLE gestisce tutto in un unico luogo. Ci inviate i vostri file CAD. I nostri ingegneri verificano il vostro progetto e vi forniscono un feedback per la produzione. Individuiamo tempestivamente i problemi di progettazione. Analizziamo il raggio di curvatura, lo spessore delle pareti e la tolleranza. Consigliamo modifiche per rendere la produzione più rapida ed economica. Dopodiché, iniziamo subito a produrre i vostri componenti. Niente scambi di informazioni con fornitori esterni. Niente spedizioni di componenti tra diversi fornitori. Nessun ritardo. Il vostro hardware necessita di un involucro che si adatti perfettamente. Il nostro processo personalizzato inizia con la progettazione per la producibilità (DFM) e termina con un involucro per il calcolo AI completo.
La nostra officina dispone sia di macchine CNC che di linee di lavorazione della lamiera. Un unico team si occupa dell'intero progetto. La lavorazione CNC realizza componenti di precisione, come dissipatori per GPU e CPU, staffe di montaggio per schede PCIe e pannelli personalizzati con ritagli precisi. Le macchine garantiscono tolleranze minime per ogni dettaglio. La lavorazione della lamiera permette di costruire il telaio. Taglio laser, piegatura di precisione e saldatura creano una struttura robusta. Con noi, un unico fornitore vi offre un case completo per il calcolo AI.
Per un progetto hardware di intelligenza artificiale, la velocità è fondamentale. Il tuo progetto necessita di un case che si adatti perfettamente. Le nostre competenze interne ci permettono di garantirlo senza tempi di attesa aggiuntivi. La qualità del tuo progetto personalizzato dipende da un controllo rigoroso. Manteniamo questo controllo eseguendo internamente ogni fase del processo. Ogni componente hardware viene testato prima di lasciare la nostra sede.
Servizi a valore aggiunto: assemblaggio di cavi e integrazione di sistemi
Il case è solo l'inizio. NOBLE si occupa anche dell'assemblaggio dei cavi e dell'integrazione del sistema. Cabliamo la distribuzione dell'alimentazione. Instradiamo i cavi dati per un flusso d'aria ottimale. Montiamo i componenti nel rack. Il tuo computer per il deep learning arriva pronto all'uso. Realizziamo cablaggi personalizzati per ogni contenitore. Cavi di alimentazione, cavi dati e cavi di segnale hanno tutti la lunghezza e i connettori giusti. Questo riduce l'ingombro all'interno del case. Un instradamento dei cavi più ordinato migliora il flusso d'aria. Il tuo sistema funziona a temperature più basse e dura più a lungo.
L'integrazione di sistema significa che testiamo tutto insieme. Verifichiamo che ogni GPU si adatti al suo slot. Confermiamo che il sistema di raffreddamento funzioni. Controlliamo che ogni connettore raggiunga la sua destinazione. Questo vi fa risparmiare ore di lavoro di assemblaggio. Il vostro team collega l'alimentazione e la rete, quindi inizia ad addestrare i modelli. Il lavoro di integrazione migliora le prestazioni complessive.
Certificazioni e Sistemi di Gestione della Qualità
ISO 9001:2015 per una gestione della qualità coerente
La norma ISO 9001:2015 definisce lo standard per la gestione della qualità. NOBLE possiede questa certificazione per tutte le sue attività. Ciò significa che seguiamo procedure documentate per ogni fase. Monitoriamo i difetti. Misuriamo le prestazioni. Miglioriamo continuamente. Il sistema individua i problemi prima che si trasformino in criticità. Le procedure documentate garantiscono che ogni membro del team segua gli stessi passaggi. Nessuna improvvisazione. Nessun controllo omesso. Il risultato è un processo prevedibile e ripetibile che garantisce la qualità in ogni occasione.
Per il vostro progetto di produzione personalizzata, questo è fondamentale. Avrete una qualità costante dalla prima alla centesima unità. Ogni contenitore rispetta le stesse tolleranze. Ogni assemblaggio segue la stessa checklist. L'infrastruttura del vostro data center dipende da hardware affidabile. La certificazione ISO 9001 vi offre questa sicurezza. La stessa qualità si applica a ogni rack che realizziamo.
Norma ISO 13485:2016 per gli standard di fabbricazione dei dispositivi medici
Le applicazioni di intelligenza artificiale in ambito medico richiedono controlli ancora più rigorosi. La norma ISO 13485:2016 è lo standard per la produzione di dispositivi medici. Anche NOBLE possiede questa certificazione. Essa copre la gestione del rischio, la tracciabilità e la validazione. Ogni componente viene documentato. Ogni processo viene sottoposto ad audit. Questo livello di dettaglio previene errori che potrebbero compromettere la sicurezza del paziente.
Questo è fondamentale per i data center di intelligenza artificiale a supporto del settore sanitario. Il vostro rack potrebbe ospitare un sistema di intelligenza artificiale diagnostica o controllare un robot chirurgico. La norma ISO 13485 garantisce che il processo soddisfi tali requisiti. La stessa disciplina apporta benefici a qualsiasi progetto infrastrutturale di alto profilo. L'infrastruttura rimane affidabile perché il processo è affidabile. Ogni componente è tracciabile fino alla sua origine. Ogni computer è costruito secondo gli standard più elevati.
Il case per il tuo sistema di calcolo AI non si limita a contenere i componenti. Influisce sulle prestazioni dell'hardware dedicato all'IA. Ogni scelta termica, ogni decisione sui materiali, ogni percorso di raffreddamento ha un impatto sui risultati dell'intelligenza artificiale. Costruire un computer per il deep learning significa pensare all'intero sistema, non solo alle specifiche di GPU e CPU.
La produzione intelligente bilancia controllo termico, resistenza strutturale ed esigenze future. Un computer per il deep learning, con un budget espandibile, necessita di spazio per crescere. Il tuo progetto personalizzato dovrebbe essere compatibile con hardware GPU di nuova generazione senza necessità di una ricostruzione completa. Questa flessibilità protegge il tuo investimento nell'infrastruttura di intelligenza artificiale.
Il case giusto trasforma un buon hardware in prestazioni eccezionali. Collabora con i produttori fin dalle prime fasi. Condividi i tuoi progetti personalizzati prima di finalizzarli. Il loro feedback eviterà costose riprogettazioni. La tua infrastruttura AI verrà implementata più velocemente. Il tuo computer funzionerà in modo più efficiente per anni. Ogni rack che riempi trarrà vantaggio da questo approccio.
Domande frequenti sulla produzione di contenitori per il calcolo AI
Perché la gestione termica è così cruciale per gli ambienti di elaborazione basati sull'intelligenza artificiale?
Le moderne GPU per l'intelligenza artificiale consumano oltre 700 W ciascuna. Un sistema con 8 GPU genera 7,000-8,000 W di calore. Senza un raffreddamento adeguato, l'hardware rallenta o smette di funzionare. Un case progettato correttamente dissipa efficacemente questo calore e protegge le apparecchiature.
Per la realizzazione del case per il mio sistema di calcolo AI, dovrei usare alluminio o acciaio?
L'alluminio (6061) dissipa rapidamente il calore dai componenti. L'acciaio (SGCC) blocca meglio le interferenze elettromagnetiche. Molti PC assemblati su misura utilizzano entrambi i materiali: alluminio per i dissipatori di calore e acciaio per il telaio esterno. La scelta del sistema di raffreddamento dipende dal tipo di scheda madre.
Come posso scegliere tra raffreddamento ad aria e raffreddamento a liquido?
Il raffreddamento ad aria è adatto a carichi medi e ha un costo inferiore. Il raffreddamento a liquido gestisce temperature estreme superiori a 40 kW per rack. Il raffreddamento a liquido diretto al chip costa dai 3,500 ai 5,000 dollari per kW. La densità dell'hardware determina l'opzione migliore. Il giusto investimento infrastrutturale dipende da questa scelta.
Di quali certificazioni ha bisogno il mio sistema di elaborazione per l'intelligenza artificiale?
La norma UL 62368-1 riguarda la sicurezza delle apparecchiature IT. La norma FCC Parte 15 regola le emissioni elettromagnetiche. La marcatura CE attesta la conformità alle normative UE. Queste certificazioni richiedono test documentati. È importante pianificarle fin dalle prime fasi del processo di produzione personalizzata.
Come posso rendere il mio contenitore a prova di futuro?
Scegli un design modulare con punti di montaggio PCIe standard. Un sistema espandibile fino a 4 GPU può essere ampliato in futuro. Questo protegge il tuo investimento infrastrutturale attraverso le generazioni hardware. Il tuo computer rimarrà funzionale per anni con semplici aggiornamenti.
Perché dovrei collaborare con un produttore già nella fase di progettazione?
Il feedback tempestivo del partner di produzione consente di individuare i difetti di progettazione prima della realizzazione degli stampi. Gli ingegneri di NOBLE esaminano i vostri file CAD per la progettazione per la producibilità (DFM). Questo previene costose riprogettazioni. L'integrazione del sistema inizia fin dal primo schizzo. La vostra infrastruttura beneficia di un controllo qualità di livello industriale.
Quali test garantiscono il funzionamento affidabile del mio contenitore?
La validazione termica combina la simulazione CFD con i test fisici. I test meccanici comprendono procedure di vibrazione, urto e caduta. Lo screening delle sollecitazioni ambientali individua i componenti deboli. L'integrazione finale include test di burn-in a pieno carico. Questo verifica che l'infrastruttura funzioni come previsto.
Posso utilizzare un case per server standard per la mia build di intelligenza artificiale?
I case standard non sono in grado di gestire la densità termica dei moderni carichi di lavoro di intelligenza artificiale. Un case personalizzato ottimizza i percorsi del flusso d'aria, il montaggio della GPU e il passaggio dei cavi. Il tuo computer per il deep learning necessita di un case progettato per i suoi specifici requisiti termici e strutturali. Il processo di produzione deve essere in linea con le tue esigenze hardware.







